構(gòu)建高容量大并發(fā)數(shù)據(jù)庫服務(wù) 分布式架構(gòu)設(shè)計(jì)核心與實(shí)踐
在當(dāng)今數(shù)據(jù)驅(qū)動(dòng)的時(shí)代,業(yè)務(wù)系統(tǒng)對數(shù)據(jù)庫提出了前所未有的挑戰(zhàn):需要處理海量數(shù)據(jù)(高容量),同時(shí)支撐成千上萬甚至百萬級(jí)的并發(fā)訪問請求(大并發(fā))。傳統(tǒng)的單機(jī)數(shù)據(jù)庫架構(gòu)已難以滿足這些需求。因此,基于分布式思想的數(shù)據(jù)庫架構(gòu)設(shè)計(jì),成為實(shí)現(xiàn)高容量、大并發(fā)數(shù)據(jù)庫服務(wù)的核心路徑。
一、 核心目標(biāo)與設(shè)計(jì)原則
設(shè)計(jì)此類數(shù)據(jù)庫服務(wù)的根本目標(biāo)是實(shí)現(xiàn)可擴(kuò)展性、高可用性和高性能。為此,需遵循幾個(gè)關(guān)鍵原則:
- 水平擴(kuò)展優(yōu)于垂直擴(kuò)展:通過增加廉價(jià)、標(biāo)準(zhǔn)的服務(wù)器節(jié)點(diǎn)來提升整體能力,而非不斷升級(jí)單臺(tái)服務(wù)器的硬件。
- 數(shù)據(jù)分片是基礎(chǔ):將單一龐大的數(shù)據(jù)集拆分到多個(gè)獨(dú)立的數(shù)據(jù)庫節(jié)點(diǎn)上,這是突破單點(diǎn)容量與性能瓶頸的關(guān)鍵。
- 冗余與副本保障可用性:任何單點(diǎn)都可能故障,必須通過數(shù)據(jù)副本(Replica)確保服務(wù)持續(xù)可用和數(shù)據(jù)安全。
- 盡可能將計(jì)算靠近數(shù)據(jù):減少網(wǎng)絡(luò)開銷,提升響應(yīng)速度。
二、 分布式數(shù)據(jù)庫架構(gòu)關(guān)鍵設(shè)計(jì)模式
1. 數(shù)據(jù)分片策略
分片決定了數(shù)據(jù)如何分布,直接影響擴(kuò)展性和查詢效率。
- 范圍分片:按某個(gè)鍵的范圍(如用戶ID區(qū)間、時(shí)間范圍)劃分。易于管理,但可能導(dǎo)致數(shù)據(jù)分布不均(熱點(diǎn))。
- 哈希分片:對分片鍵進(jìn)行哈希計(jì)算,根據(jù)哈希值分配數(shù)據(jù)。能保證數(shù)據(jù)均勻分布,但范圍查詢效率低。
- 一致性哈希:哈希分片的優(yōu)化,在節(jié)點(diǎn)增刪時(shí)能最小化數(shù)據(jù)遷移量,被廣泛用于分布式緩存和數(shù)據(jù)庫系統(tǒng)。
2. 復(fù)制與一致性模型
復(fù)制提供數(shù)據(jù)冗余和讀寫分離能力,但引入了數(shù)據(jù)一致性問題。
- 主從復(fù)制:一個(gè)主節(jié)點(diǎn)負(fù)責(zé)寫,多個(gè)從節(jié)點(diǎn)異步同步數(shù)據(jù)并承擔(dān)讀請求。實(shí)現(xiàn)簡單,讀擴(kuò)展性好,但存在數(shù)據(jù)同步延遲(最終一致性)。
- 多主復(fù)制:多個(gè)節(jié)點(diǎn)均可寫入,需解決寫沖突。適用于多地域部署。
- 基于共識(shí)協(xié)議(如Raft、Paxos)的同步復(fù)制:如NewSQL數(shù)據(jù)庫所采用,能保證強(qiáng)一致性,但通常以寫入延遲為代價(jià)。
3. 無狀態(tài)計(jì)算與存儲(chǔ)分離
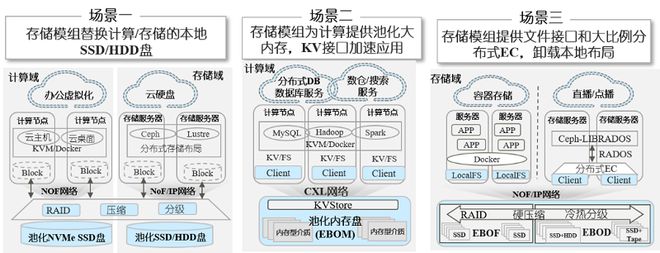
現(xiàn)代云原生數(shù)據(jù)庫常采用此架構(gòu)。將負(fù)責(zé)SQL解析、查詢優(yōu)化、事務(wù)管理的計(jì)算層設(shè)計(jì)為無狀態(tài)節(jié)點(diǎn),而將數(shù)據(jù)持久化存儲(chǔ)在獨(dú)立的、可擴(kuò)展的存儲(chǔ)層(如分布式文件系統(tǒng)、對象存儲(chǔ)或定制的存儲(chǔ)引擎)。這種分離使得計(jì)算和存儲(chǔ)可以獨(dú)立彈性伸縮。
4. 全局事務(wù)管理與分布式查詢
跨分片的事務(wù)和復(fù)雜查詢是分布式數(shù)據(jù)庫的難點(diǎn)。
- 分布式事務(wù):可采用兩階段提交(2PC)等協(xié)議,但性能開銷大。許多系統(tǒng)選擇放寬一致性(如最終一致性)或使用Saga等長事務(wù)解決方案。
- 分布式查詢:查詢引擎需要能將一個(gè)SQL查詢分解為能在多個(gè)分片上執(zhí)行的子查詢,并進(jìn)行結(jié)果匯總(如MapReduce思想)。
三、 技術(shù)棧選型與實(shí)踐路徑
- 路線一:采用成熟分布式數(shù)據(jù)庫產(chǎn)品
- NewSQL:如TiDB、CockroachDB。它們兼容MySQL或PostgreSQL協(xié)議,內(nèi)置分片、強(qiáng)一致復(fù)制和分布式事務(wù),對應(yīng)用透明,是快速構(gòu)建服務(wù)的首選。
- 云服務(wù)商托管服務(wù):如AWS Aurora、阿里云PolarDB。它們基于共享存儲(chǔ)和日志即數(shù)據(jù)庫理念,提供了類似單機(jī)的使用體驗(yàn)和近乎無限的擴(kuò)展能力。
- 路線二:基于開源組件自研架構(gòu)
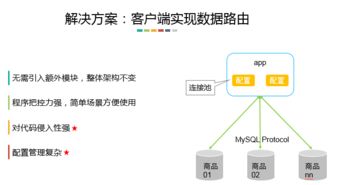
- 分庫分表中間件:使用ShardingSphere、Vitess等。它們在應(yīng)用層與數(shù)據(jù)庫之間進(jìn)行攔截和路由,實(shí)現(xiàn)分片和讀寫分離,需要業(yè)務(wù)層配合。
- “數(shù)據(jù)庫+”組合方案:例如,用MySQL/PostgreSQL進(jìn)行分庫分表存儲(chǔ),用Redis作為緩存和會(huì)話存儲(chǔ),用Elasticsearch處理復(fù)雜搜索,用消息隊(duì)列解耦異步任務(wù)。此方案靈活,但技術(shù)復(fù)雜度和運(yùn)維成本高。
四、 實(shí)施要點(diǎn)與挑戰(zhàn)
- 分片鍵選擇:至關(guān)重要,應(yīng)選擇查詢頻繁、數(shù)據(jù)分布均勻的字段,避免跨分片查詢。
- 數(shù)據(jù)再平衡:當(dāng)集群節(jié)點(diǎn)變化時(shí),系統(tǒng)應(yīng)能自動(dòng)平滑地遷移數(shù)據(jù),保持負(fù)載均衡。
- 監(jiān)控與運(yùn)維:分布式系統(tǒng)復(fù)雜度呈指數(shù)增長,必須建立完善的監(jiān)控體系(如Prometheus + Grafana),覆蓋每個(gè)節(jié)點(diǎn)的健康度、性能指標(biāo)、數(shù)據(jù)同步延遲等。
- 測試:必須進(jìn)行大規(guī)模的壓力測試、故障注入測試(如Chaos Engineering),驗(yàn)證系統(tǒng)的彈性與恢復(fù)能力。
###
實(shí)現(xiàn)高容量大并發(fā)的數(shù)據(jù)庫服務(wù),本質(zhì)上是將復(fù)雜性從使用階段轉(zhuǎn)移到設(shè)計(jì)與管理階段。沒有“銀彈”,最佳架構(gòu)始終取決于具體的業(yè)務(wù)場景、數(shù)據(jù)模型和一致性要求。從清晰的原則出發(fā),結(jié)合成熟的技術(shù)組件,并持續(xù)進(jìn)行容量規(guī)劃與性能優(yōu)化,才能構(gòu)建出既健壯又高效的分布式數(shù)據(jù)庫服務(wù)體系,為業(yè)務(wù)的飛速發(fā)展奠定堅(jiān)實(shí)的數(shù)據(jù)基石。
如若轉(zhuǎn)載,請注明出處:http://m.zibotechan.cn/product/32.html
更新時(shí)間:2026-11-13 23:10:48